
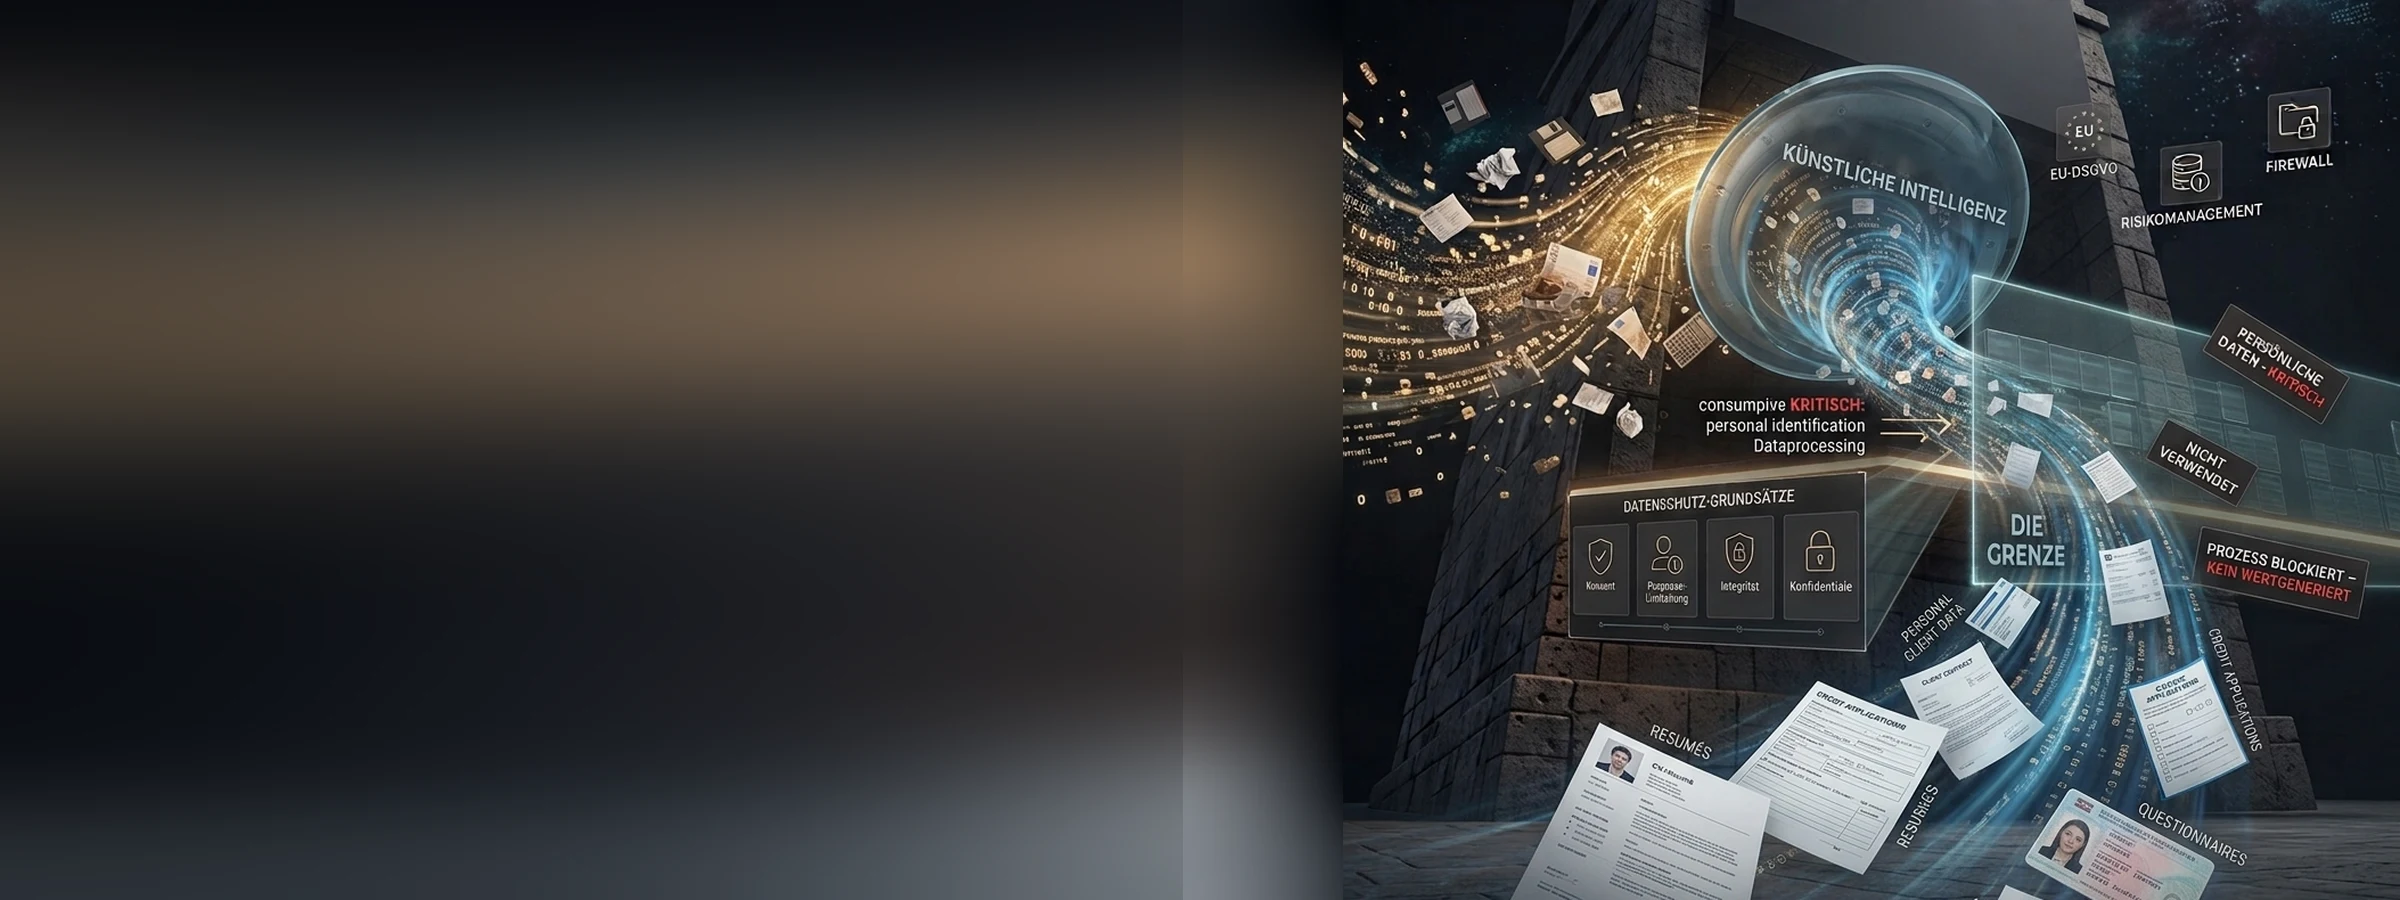
„Zuerst prüfen wir, ob wir diese Daten überhaupt in eine KI geben dürfen."
Mit diesem Satz beginnt meist das Gespräch über KI-Einführung im Unternehmen. Und genau hier passiert der häufigste Fehler.
Die Frage ist nicht falsch. Sie ist nur unvollständig. Dieselben Daten – etwa der Lebenslauf eines Bewerbers – können in einem Anwendungsfall völlig unproblematisch sein und im nächsten ein ernsthaftes rechtliches Risiko darstellen. Der Unterschied liegt nicht in den Daten. Er liegt darin, was die KI damit tut.
Schauen wir uns das an einem Beispiel an, dann an dem, was das Gesetz dazu sagt, welche Irrtümer Unternehmen am teuersten zu stehen kommen – und womit man anfangen sollte, wenn man KI-Automatisierung im eigenen Unternehmen einführen will.
Ein Dokument, drei verschiedene Antworten
Nehmen wir einen gewöhnlichen Bewerber-Lebenslauf.
Grüne Zone. Die KI liest den Lebenslauf aus und strukturiert die Daten – extrahiert Name, Erfahrung, Skills, bringt alles in ein einheitliches Format für die interne Datenbank. Das ist normale Automatisierung. Personenbezogene Daten sind in diesem Lebenslauf enthalten, und die DSGVO gilt unabhängig davon, ob ein Mensch oder ein Algorithmus sie verarbeitet. Aber dieses Szenario wird dadurch nicht automatisch zu einem Hochrisikosystem.
Orange Zone. Dieselbe KI strukturiert den Lebenslauf jetzt nicht mehr nur, sondern bewertet Bewerber und schlägt vor, wen man einlädt. Hier ändert sich die Lage grundlegend. KI-Systeme für Recruiting, Auswahl und Bewertung von Kandidaten fallen nach dem EU AI Act ausdrücklich in den Bereich mit erhöhtem Risiko (Anhang III der Verordnung (EU) 2024/1689, Nr. 4 – „Employment, workers management and access to self-employment"). Und das Argument „am Ende schaut ja noch ein Mensch drauf" reicht hier nicht automatisch aus: Das Gesetz verlangt keine formale Kontrolle, sondern echte menschliche Aufsicht.
Rote Zone. Würde dasselbe System stattdessen die Emotionen von Bewerbern im Videointerview auswerten, ginge es nicht mehr um erhöhte Anforderungen, sondern um ein Verbot. Art. 5 EU AI Act ordnet Emotionserkennung am Arbeitsplatz den verbotenen KI-Praktiken zu – mit einem eng gefassten Katalog an Ausnahmen.
Derselbe Datentyp. Drei völlig unterschiedliche Rechtsregime – je nachdem, was das System tatsächlich tut.
Warum ein einzelnes Gesetz nicht ausreicht
Die KI-Regulierung in der EU ist kein einzelnes Dokument, sondern mindestens drei ineinandergreifende Gesetze.
DSGVO beantwortet die Fragen: Auf welcher Grundlage werden Daten verarbeitet, zu welchem Zweck, wie viele Daten braucht man wirklich, und was passiert, wenn eine Entscheidung vollständig automatisiert getroffen wird (Art. 22 DSGVO – das Recht, keiner ausschließlich auf automatisierter Verarbeitung beruhenden Entscheidung unterworfen zu werden, wenn diese rechtliche oder ähnlich erhebliche Auswirkungen hat). Eine eigene Kategorie sind Gesundheitsdaten, biometrische Daten, Angaben zur ethnischen Herkunft und Ähnliches (Art. 9 DSGVO): Für sie gelten strengere Verarbeitungsregeln.
EU AI Act ist das neuere Gesetz, das stufenweise in Kraft getreten ist. Er fragt nicht, ob Daten rechtmäßig erhoben wurden – das ist Sache der DSGVO. Er fragt: Wie riskant ist das KI-System selbst? Verbotene Praktiken (Art. 5) gelten bereits seit dem 2. Februar 2025. Die Pflicht zur KI-Kompetenz des Personals (Art. 4) ebenfalls seit diesem Datum. Die vollen Pflichten für Hochrisikosysteme und die Bußgeldregelungen des AI Act greifen ab dem 2. August 2026.
BDSG ist das deutsche Gesetz, das die DSGVO um nationale Regelungen ergänzt und einzelne Punkte präzisiert, die die Verordnung den Mitgliedstaaten überlässt.
In der Praxis bedeutet das: Die Einhaltung eines Gesetzes garantiert nicht die Einhaltung der anderen. Ein Unternehmen kann DSGVO-konform arbeiten und gleichzeitig ein System betreiben, das nach dem EU AI Act als Hochrisikosystem gilt – oder umgekehrt.
Warum das kein abstraktes Problem ist
Laut einer repräsentativen Bitkom-Umfrage unter 603 deutschen Unternehmen ab 20 Beschäftigten (März 2025) sieht sich nur jedes zehnte Unternehmen (10 %) als Vorreiter bei KI. Zwei Drittel (64 %) bezeichnen sich als Nachzügler, und jedes fünfte (22 %) glaubt, den Anschluss bereits verpasst zu haben.
Als größte Hemmnisse nennen Unternehmen rechtliche Unsicherheit – 53 %, hohe Anforderungen an den Datenschutz – 48 %, und die Sorge, dass Daten in falsche Hände geraten – 39 % (Bitkom Research, „Künstliche Intelligenz 2025"). Unternehmen bremsen die KI-Einführung also nicht, weil sie den Nutzen nicht sehen, sondern weil ihnen unklar ist, wo genau die Grenze des Erlaubten verläuft. Die fünf Sätze unten sind genau der Punkt, an dem diese Unsicherheit am häufigsten zu einem konkreten Fehler wird.
Fünf Sätze, die teuer werden
In Automatisierungsprojekten fallen immer wieder dieselben Formulierungen. Jede klingt vernünftig. Keine hält der Prüfung stand.
„Wir haben die Namen entfernt – die Daten sind anonym." Nicht unbedingt. Lässt sich eine Person über andere Merkmale identifizieren, bleiben es personenbezogene Daten – auch ohne Namen.
Ein Beispiel: In der Krankenakte eines Patienten wurden Vor- und Nachname entfernt, aber die Diagnose einer seltenen Erkrankung, der Monat der Diagnose und die Behandlungsstadt blieben stehen. Für sich genommen sagen diese Angaben nichts. Zusammen ergeben sie bereits einen fast eindeutigen Fingerabdruck: Eine seltene Erkrankung, in einer kleinen Stadt, in einem bestimmten Monat dokumentiert, kann auf eine einzige Person hindeuten – besonders wenn jemand zusätzlich weiß, dass ein Kollege genau in diesem Zeitraum krankgeschrieben war. Anonymisierung bedeutet nicht, eine Spalte aus der Tabelle zu löschen. Sie ist die Garantie, dass sich die verbleibende Datenkombination niemandem zuordnen lässt – weder jetzt noch später, wenn neue Vergleichsquellen auftauchen.
„Unser KI-Anbieter ist DSGVO-konform." Möglich. Das macht Ihren eigenen Prozess aber nicht automatisch konform. Die Konformität des Anbieters betrifft, wie er selbst Daten verarbeitet. Zweck der Verarbeitung, Rechtsgrundlage, wer Zugriff hat, wo die Daten liegen und welche Subunternehmer der Anbieter einsetzt – dafür ist verantwortlich, wer Zwecke und Mittel der Verarbeitung festlegt, also in der Regel Ihr Unternehmen.
„Am Ende schaut ja noch ein Mensch drauf." Für Hochrisikosysteme reicht das nicht. Art. 14 EU AI Act verlangt eine wirksame menschliche Aufsicht – der Mensch muss also wirklich verstehen, wie das System arbeitet, Fehler erkennen können und in der Lage sein, einzugreifen.
Ein Beispiel: Ein System bewertet 200 Bewerbungen und übergibt der HR-Managerin die Top 5. Sie prüft diese gewissenhaft und bestätigt die Liste. Formal hat ein Mensch „das Ergebnis geprüft". Aber sie hat die übrigen 195 Bewerbungen nie gesehen und kann nicht bemerken, dass das System zum Beispiel Kandidat:innen mit Erwerbslücken systematisch niedriger bewertet. Eine Aufsicht, die nur sieht, was der Algorithmus ihr bereits gezeigt hat, kann dessen Fehler nicht erkennen.
„Die KI entscheidet ja nichts, sie fasst nur zusammen." Auch eine Zusammenfassung verarbeitet personenbezogene Daten und unterliegt der DSGVO. Und aus einer „bloßen Empfehlung" wird in der Praxis viel zu oft eine Entscheidung: Der Mensch übernimmt den Vorschlag des Algorithmus, einfach weil es schneller geht – und dann hat faktisch die Maschine entschieden, nur ohne dass jemand formal dafür geradesteht.
„Mehr KI heißt bessere Automatisierung." Nicht immer. Lässt sich ein Dokument nach einer klaren Regel verarbeiten – etwa feste Felder aus einem Standardformular extrahieren –, braucht es dafür oft kein Sprachmodell. Das bringt dort unnötige Unvorhersehbarkeit, Kosten und Risiken, wo einfacher Code mit klaren Regeln zuverlässiger und günstiger arbeitet.
Was das in der Praxis bedeutet
Die Bußgelder für DSGVO-Verstöße steigen – und das nicht nur für Großunternehmen. Seit Mai 2018 wurden europaweit über 7,1 Mrd. Euro Bußgeld in mehr als 2.800 Verfahren verhängt (Jahresbericht des Europäischen Datenschutzausschusses, EDPB Annual Report 2025, veröffentlicht im April 2026).
Ein aufschlussreiches Beispiel dafür, was Aufsichtsbehörden tatsächlich prüfen, ist der Fall British Airways (ICO, Vereinigtes Königreich, 2019). Das Bußgeld wurde nicht für den Cyberangriff selbst verhängt, sondern für das Fehlen grundlegender, damals längst üblicher Schutzmaßnahmen – Multi-Faktor-Authentifizierung und Netzwerksegmentierung. Ein weiteres Beispiel ist das Bußgeld gegen Amazon in Luxemburg (746 Mio. Euro, 2021) wegen Verstoßes gegen grundlegende Einwilligungsprinzipien bei personalisierter Werbung: nicht für die Datennutzung an sich, sondern weil die Einwilligung der Nutzer:innen nicht korrekt eingeholt wurde.
In beiden Fällen ging es nicht darum, dass die Unternehmen das Gesetz vorsätzlich gebrochen hätten. Es ging darum, dass sie der Behörde nicht erklären konnten, warum ihre Maßnahmen dem Risiko angemessen waren – sie sind also genau in eine der oben beschriebenen Fallen getappt.
Und die Unternehmensgröße spielt dabei eine immer kleinere Rolle. Mehreren Meldungen deutscher Landesdatenschutzbeauftragter zufolge stieg 2025 die Zahl der Verfahren gegen Unternehmen mit weniger als 250 Beschäftigten spürbar gegenüber dem Vorjahr. Die Kontrolle weitet sich nicht nur auf Konzerne wie Meta oder Amazon aus.
Womit man statt der Modellwahl beginnen sollte
Einen falschen Prozess mit KI zu automatisieren heißt nur, den Fehler schneller und in größerem Maßstab zu machen. Bevor Sie also ein Modell oder Tool wählen, lohnt es sich, fünf Fragen zu beantworten:
- PROCESS – Was automatisieren wir genau?
- DATA – Welche Daten brauchen wir wirklich für diese Aufgabe?
- PURPOSE – Warum braucht die KI Zugriff auf genau diese Daten?
- DECISION – Unterstützt die KI eine menschliche Entscheidung, oder trifft sie sie vollständig selbst?
- RISK – Was passiert, wenn die KI sich irrt, und wer bemerkt es?
Die ersten beiden Fragen – Process und Data – hängen unmittelbar mit dem Grundsatz der Datenminimierung zusammen (Art. 5 DSGVO): Das System soll nicht den gesamten im Unternehmen vorhandenen Datenbestand erhalten, sondern genau das, was für die konkrete Aufgabe nötig ist. Die Frage Decision entscheidet, ob der Anwendungsfall unter Art. 22 DSGVO und die Hochrisiko-Kategorie des EU AI Act fällt. Und die Frage Risk ist im Grunde der Anfang genau jener dokumentierten Risikobewertung, die Art. 5 Abs. 2 DSGVO im Prüfungsfall vorweisbar verlangt – wobei die Begründung zum Zeitpunkt der Einführung des Systems bestanden haben muss, nicht erst nachträglich entstehen darf, wenn bereits Fragen aufgekommen sind.
Fazit
Die Grenze zwischen „normaler Automatisierung" und „Hochrisikosystem" verläuft nicht dort, wo die meisten Unternehmen sie vermuten – nicht zwischen „persönlichen" und „nicht-persönlichen" Daten, und nicht schon beim bloßen Einsatz von KI.
Sie verläuft dort, wo ein System aufhört, Informationen zu strukturieren, und anfängt, damit Menschen zu bewerten oder Entscheidungen über sie zu treffen.
Gute KI-Automatisierung bedeutet nicht, dass die KI Zugriff auf alles bekommt. Sie bedeutet, dass sie genau die Daten und Befugnisse erhält, die für die konkrete Aufgabe nötig sind – und dass das Unternehmen im Voraus erklären kann, warum genau so.