
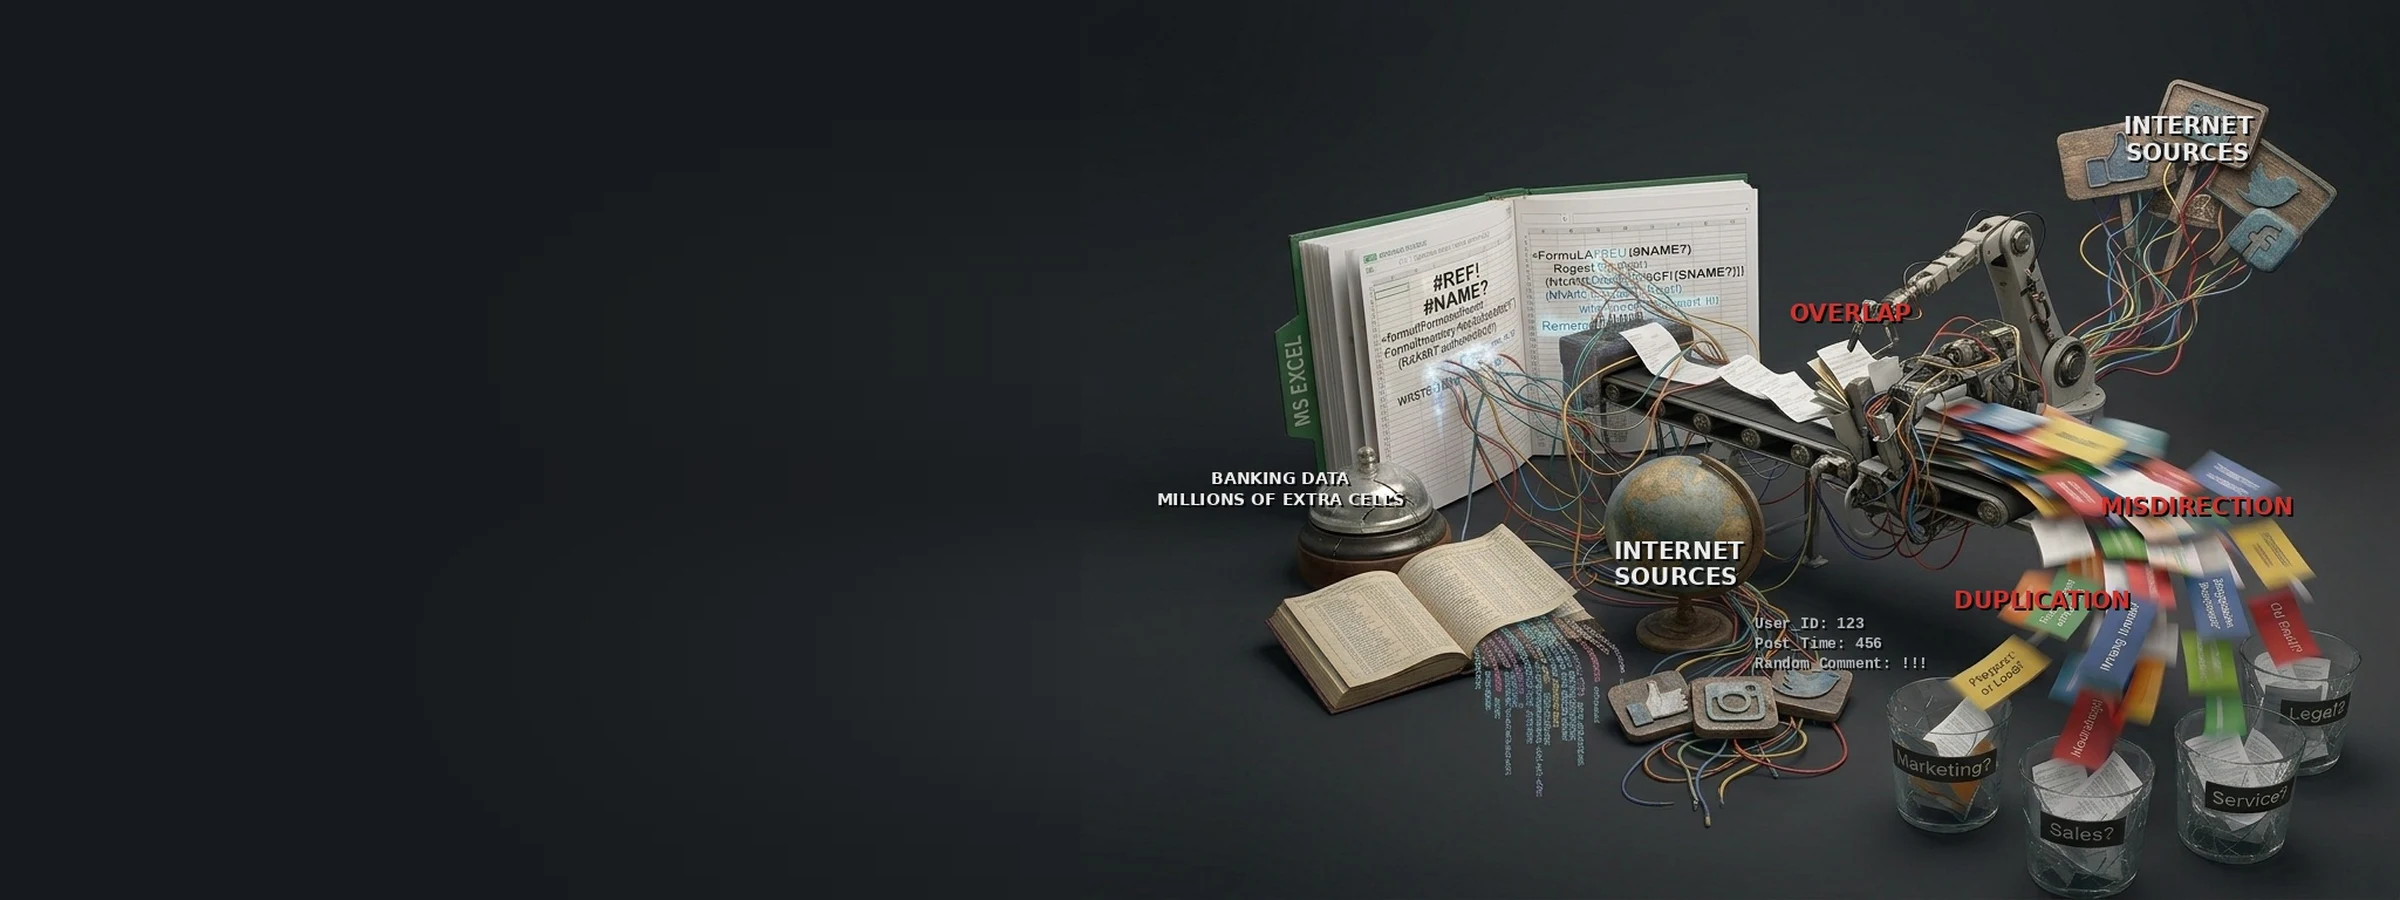
Die Automatisierung lief fehlerfrei durch. Der Kunde erhielt trotzdem drei identische E-Mails.
Im CRM standen:
- → Müller GmbH
- → Mueller GmbH
- → Müller
Sie sehen ein Unternehmen. Die Automatisierung sieht möglicherweise drei.
An dieser Stelle heißt es nicht selten: „Wir haben ein Problem mit der Automatisierung.“ Doch sehr oft liegt die Ursache viel früher. Die Automatisierung hat sie nur sichtbar gemacht. Und zwar im großen Stil.
Automatisierung korrigiert keine Daten. Sie vervielfältigt deren Fehler, und zwar schnell.
Warum eine „saubere“ Datenbank noch nicht automatisierungsbereit ist
Vor einer Automatisierung prüft man meist das Naheliegende: Gibt es Dubletten? Sind die Pflichtfelder ausgefüllt? Stimmen die E-Mail-Adressen? Wenn ja, gilt die Datenbank als sauber.
Doch korrekte Daten sind nicht automatisch gute Daten. Formal ist alles in Ordnung: Die Felder sind gefüllt, das CRM meldet keinen einzigen Fehler. Und trotzdem liefert das Geschäft ein falsches Ergebnis: mehrere Deals statt eines, identische E-Mails an denselben Kunden, überflüssige Datensätze im ERP, verzerrte Berichte.
Das stützen auch Studien. Gartner stellte in einer Umfrage unter Verantwortlichen für Datenmanagement (Juli 2024) fest: 63 % der Organisationen haben entweder keine geeigneten Datenmanagement-Praktiken für KI oder sind sich nicht sicher, ob sie welche haben. Dazu kommt eine Prognose der Analysten: Bis Ende 2026 werden Organisationen 60 % der KI-Projekte aufgeben, für die keine aufbereiteten Daten vorliegen.* In diesen Studien geht es um KI. Das Problem reicht aber weiter: Daten, die nicht auf Automatisierung vorbereitet sind, behindern jede Automatisierung, mit KI genauso wie ohne.
Wie ich Probleme finde und in Zonen einteile
Wenn ich mir CRM-Daten vor einer Automatisierung ansehe, suche ich nicht nach Dubletten oder leeren Feldern. Das ist das Offensichtliche, und das hat meist schon jemand geprüft. Mich interessieren Probleme, die weit über eine übliche Datenbereinigung hinausgehen. Sie haben eines gemeinsam: Im System sehen sie wie ganz normale Daten aus. Deshalb fallen sie niemandem auf, bis die Automatisierung läuft.
Damit man mit ihnen arbeiten kann, teile ich sie nach einem einzigen Kriterium in drei Zonen ein: Was passiert mit dem Ergebnis, wenn alles bleibt, wie es ist?
Rote Zone. Die Automatisierung liefert ein falsches Ergebnis oder bleibt stehen: E-Mails gehen an die falschen Personen, Rechnungen werden falsch gestellt, ein Vertrag wird nicht angelegt, der Bericht zeigt falsche Zahlen. Hier ist der Preis eines Fehlers am höchsten, denn nach dem Versand von Mails und Rechnungen muss man ihn gleich in mehreren Systemen korrigieren. Deshalb behebe ich Rotes vor dem Start.
Orange Zone. Das Ergebnis stimmt, aber um den Preis von Handarbeit und ständigem Pflegeaufwand. Das ist kein Störfall, sondern ein stiller Verlust an Zeit und Geld, den kaum jemand zählt. Deshalb nehme ich Orangefarbenes in den Plan auf: Was zuerst drankommt, bestimmt die Zeit, die es verschlingt.
Grüne Zone. Daten, die die Automatisierung nicht nutzt. Hier muss zunächst nichts passieren, bis sie an der Reihe sind.
Nun zu jeder Zone: Was man in Unternehmen dazu hört, wie es die Arbeit stört und was ich konkret tue.
Rote Zone: verfälscht das Ergebnis. Klärung vor dem Start
„Bei uns weiß jeder, was ein ‚aktiver Kunde‘ ist“
Was dahintersteckt. Im CRM gibt es das Feld Customer Status mit dem Wert Active. Es ist gefüllt und sieht ordentlich aus. Fragt man aber drei Abteilungen, was „aktiv“ bedeutet, fallen die Antworten oft unterschiedlich aus:
- Vertrieb: Das ist, mit wem gerade verhandelt wird oder wer einen offenen Deal hat.
- Buchhaltung: Das ist, wer zahlt, einen laufenden Vertrag hat und dem Rechnungen gestellt wurden.
- Support: Das ist, wer sich zuletzt gemeldet hat oder das Produkt nutzt.
Keiner von ihnen irrt. Sie sprechen nur über verschiedene Dinge. Die Daten sind „richtig“, haben aber keine gemeinsame Bedeutung.
Wie das die Automatisierung stört. Eine Automatisierungsregel ist eine Definition, übersetzt in eine Bedingung. Gibt es keine Definition, erfindet im Grunde die Person die Bedingung, die sie einrichtet. Beispiele, was passieren kann (sie sind illustrativ, keine dokumentierten Fälle):
- Die Regel „Active → Angebot senden“ erreicht sowohl Kontakte, die nur ein Konto angelegt haben, als auch solche, die lange nicht gezahlt haben. Ein Rabattangebot an einen Kunden mit offener Forderung wirkt unglücklich.
- Den Bericht „Anzahl aktiver Kunden“ zählen Vertrieb und Finanzen unterschiedlich. In der Besprechung liegen zwei Zahlen auf dem Tisch, und zuerst muss geklärt werden, welche stimmt.
- Die Regel „Active → Verlängerungsrechnung erstellen“ schickt eine Rechnung an einen Kunden, dessen Vertrag bereits ausgelaufen ist.
- Die Regel „Active → Support-Betreuer zuweisen“ überlastet das Team mit Kunden, die längst weg sind.
Was ich tue. Das betrifft nicht nur den Status. Genauso kann man „qualifizierter Lead“, „Großkunde“, „priorisierter Deal“ oder „Verantwortlicher“ unterschiedlich verstehen. Deshalb gehe ich alle Felder durch, auf die sich die künftige Automatisierung stützt:
1. Ich schreibe diese Felder auf, dazu alle Werte, die jedes von ihnen annehmen kann. 2. Ich frage zwei bis drei Abteilungen, was jeder Wert für sie in eigenen Worten bedeutet. Die Antworten notiere ich nebeneinander. 3. Wo die Antworten auseinandergehen, einigen wir uns auf eine einheitliche Formulierung in einem Satz mit prüfbarer Bedingung. Zum Beispiel: „Active = es gibt eine bezahlte Rechnung in den letzten 12 Monaten.“ Den Zeitraum nenne ich hier nur als Beispiel, jedes Unternehmen hat seinen eigenen. 4. Ich halte fest, wer den Wert ändern darf und in welchen Fällen, und welches System als führend gilt, wenn die Daten voneinander abweichen.
Warum das wichtig ist: Solange die Definition nicht aufgeschrieben ist, arbeitet jede Automatisierungsregel nach der Version einer einzelnen Person, und die anderen erfahren es am Ergebnis.
„Wir haben geprüft: keine leeren Felder, keine Dubletten“
Was dahintersteckt. Jeder Wert wirkt für sich normal. Der Fehler zeigt sich erst in der Kombination zweier Felder. Diese Kombinationen prüfe ich zuerst:
- ein Deal mit Status Closed Won, aber 0 € Umsatz;
- ein Kunde mit Status Active, dessen letzte Bestellung vier Jahre zurückliegt;
- ein Kontakt ohne E-Mail-Adresse, der trotzdem im E-Mail-Verteiler steht;
- eine Rechnung, die als „bezahlt“ markiert ist, bevor sie erstellt wurde;
- ein Deal, der geschlossen wurde, bevor der Kontakt angelegt war;
- ein Deal-Verantwortlicher, der gar nicht mehr im Unternehmen arbeitet.
Wie das die Automatisierung stört.
- Closed Won bei 0 € Umsatz kann den Bericht verzerren („gewonnene“ Deals, aber kein Geld) oder eine Rechnung über 0 € auslösen.
- Ein Kontakt ohne Adresse im Verteiler kann die Automatisierung an dieser Stelle stoppen oder lahmlegen. Die E-Mails nach diesem Eintrag gehen mitunter einfach nicht raus, und man merkt es erst an den Beschwerden.
- Ist der Deal-Verantwortliche längst ausgeschieden, landen die Aufgaben bei jemandem, der sie nie liest. Der Kunde wartet, und im System sieht alles in Ordnung aus.
- Eine Rechnung, die vor ihrer Erstellung bezahlt wurde, kann die automatische Zahlungserinnerung oder den Periodenabschluss durcheinanderbringen.
Was ich tue. Ich suche nicht nach leeren Feldern, sondern nach unmöglichen Kombinationen:
1. Ich schreibe die Felder auf, die an den Regeln der Automatisierung beteiligt sind. 2. Für jedes Paar solcher Felder frage ich: Welche Wertekombination ist im realen Prozess unmöglich? So entsteht eine Liste von fünf bis zehn Regeln nach dem Muster „So etwas kommt nicht vor“. 3. Ich prüfe die Datenbank gegen diese Regeln. Meist genügt ein Filter im CRM selbst oder ein Export in eine Tabelle. Ich zähle, wie viele Einträge jede Regel verletzen. 4. Für jeden Verstoß entscheide ich, was geschieht: den Eintrag korrigieren, die Kombination schon bei der Eingabe verhindern oder sie in der Automatisierungsregel selbst berücksichtigen (zum Beispiel: „Wenn die Adresse fehlt, Eintrag überspringen und die verantwortliche Person informieren“).
Warum das wichtig ist: Die übliche Prüfung auf ausgefüllte Felder übersieht genau diese Fälle, und sie fallen erst auf, wenn die Automatisierung schon läuft.
„Wir laden die ganze Datenbank und korrigieren unterwegs“
Was dahintersteckt. Alles auf einmal zu laden, wirkt schneller. Ein Mensch, der Müller GmbH und Mueller GmbH sieht, versteht: Das ist ein Unternehmen. Er „verschmilzt“ die Einträge im Kopf in einer Sekunde und rechnet deshalb nicht mit Ärger.
Wie das die Automatisierung stört. Die Automatisierung weiß das nicht, wenn die Einträge unterschiedliche IDs haben. Sieht sie drei Firmen, kann sie:
- drei Deals anlegen und drei Rechnungen stellen statt einer;
- dem Kunden dreimal dieselbe E-Mail schicken;
- den Bericht aufblähen, sodass es mehr Kunden gibt, als tatsächlich existieren;
- drei Datensätze im ERP anlegen. Die Zahlung geht dann auf einen ein, die beiden anderen bleiben „unbezahlt“ und lösen womöglich Zahlungserinnerungen aus.
Korrigieren muss man das erst, nachdem E-Mails und Rechnungen längst raus sind, und zwar in mehreren Systemen.
Was ich tue. Ich beginne mit einem einzigen Kunden, nicht mit der Datenbank:
1. Ich nehme ein reales Unternehmen mittlerer Komplexität, nicht das einfachste. 2. Ich verfolge seinen Weg: Lead → Contact → Company → Deal → Order → Invoice → Support. In jedem System notiere ich ID, Namen, Status, Verantwortlichen und Adresse. 3. Ich vergleiche. Ist es jeweils derselbe Eintrag? Stimmen ID, Schreibweise, Status und Verantwortlicher überein? 4. Wenn nicht, kläre ich, welches System die Quelle der Wahrheit ist und woran ein System erkennt, dass zwei Einträge dasselbe Unternehmen sind (ID, Umsatzsteuer-ID, E-Mail-Domain). 5. Ich korrigiere die gefundenen Abweichungen. Dann wiederhole ich das Ganze mit zehn Kunden, danach mit hundert. Erst dann lade ich die gesamte Datenbank.
Warum das wichtig ist: Ein Kunde zeigt die Schwachstellen des Prozesses in zehn Minuten. Hunderttausend Einträge zeigen sie, wenn die Korrektur schon teuer ist.
„Die Daten kommen aus dem Formular, der Kunde gibt sie selbst ein, was soll da schiefgehen?“
Was dahintersteckt. Daten gelangen nicht nur durch Mitarbeitende ins CRM, sondern aus externen Quellen: Formulare auf der Website, Anfrageformulare, E-Mails, Importe aus anderen Systemen. Der Kunde schreibt, wie es ihm passt. Der Computer liest streng.
Wie das die Automatisierung stört. Ein Beispiel aus meiner Praxis: Ein Kunde füllte das Formular aus, und in seiner Adresse standen Anführungszeichen. Dieses Feld sollte die Automatisierung in ein anderes System übertragen, und dieses System konnte die Anführungszeichen nicht lesen. Die Automatisierung blieb stehen, und für diese Person wurde schlicht kein Vertrag angelegt. Dabei sah kein Eintrag „schmutzig“ aus: Der Kunde hatte seine echte Adresse eingegeben.
Ähnlich können sich auch andere Dinge verhalten (diese Beispiele sind illustrativ, keine dokumentierten Fälle):
- ein Apostroph oder Anführungszeichen im Firmennamen, etwa in einem Nachnamen mit Apostroph;
- Umlaute und ß in einem System, das nur lateinische Buchstaben ohne Sonderzeichen akzeptiert;
- ein Zeilenumbruch mitten im Adressfeld oder überflüssige Leerzeichen am Anfang und Ende;
- ein sehr langer Text in einem Feld mit Längenbegrenzung;
- eine Telefonnummer im Format „+49 (0) 40 …“, wo nur Ziffern erwartet werden.
Gefährlich ist, dass ein solcher Fehler häufig still bleibt. Die Automatisierung ist stehen geblieben oder hat den Eintrag übersprungen, und der Kunde bekommt einfach keinen Vertrag. Man erfährt es erst, wenn er anruft und nachfragt.
Was ich tue. Ich prüfe den Weg der Daten vom Menschen bis ins letzte System:
1. Ich schreibe alle Felder auf, die Kunden eingeben oder die von außen kommen, und schaue für jedes, wohin es weitergeht: in welches System, in welches Feld, welchen Typs, mit welcher Längen- und Zeichenbegrenzung. 2. Ich teste den Weg mit „unbequemen“ Werten: Anführungszeichen und Apostrophe, Umlaute, Leerzeichen am Rand, Zeilenumbruch, sehr langer Text. Ich muss sehen, wo genau die Daten brechen, solange es noch ein Test ist. 3. Ich entscheide, wo ich ansetze: bei der Eingabe (das Formular lehnt ab oder bereinigt selbst), in der Automatisierung (sie bereitet den Wert vor der Übergabe auf) oder im empfangenden System. 4. Ich stelle unbedingt die Frage: Was geschieht mit einem Eintrag, der sich nicht verarbeiten ließ? Die richtige Antwort lautet nicht „Die Automatisierung bleibt stehen“, sondern „Der Eintrag landet in einer Warteschlange zur manuellen Prüfung, die verantwortliche Person wird benachrichtigt, die übrigen Einträge laufen weiter.“
Warum das wichtig ist: Ein Fehler in einem einzigen Formular darf nicht den Prozess für alle stoppen, und erst recht nicht unbemerkt bleiben.
„Bei uns ist alles klar: Rot markiert sind die Problemkunden, in den Kommentaren steht alles drin“
Was dahintersteckt. In Tabellen und sogar im CRM steckt die Bedeutung oft nicht in den Daten, sondern in der Formatierung: Eine Zelle ist rot oder gelb eingefärbt, an einer Zelle hängt ein Kommentar, eine Zeile ist ausgeblendet oder durch die Schrift hervorgehoben. Für das Team ist das verständlich. Doch nicht selten haben die Farben schon innerhalb des Teams unterschiedliche Bedeutungen: Für die eine Kollegin heißt Rot „nicht anrufen“, für die andere „dringend anrufen“. Und neue Mitarbeitende wissen nicht, was die Farben bedeuten, bis es ihnen jemand erklärt.
Wie das die Automatisierung stört. Eine Automatisierung liest Feldwerte. Die Füllfarbe einer Zelle und ein Zellenkommentar werden beim Export als CSV oder beim Import in der Regel gar nicht übertragen. Für die Automatisierung existieren sie schlicht nicht. Beispiele (illustrativ):
- Rot markiert sind Kunden, denen man nicht schreiben darf. Die Automatisierung sieht das nicht, und der Newsletter geht an alle.
- Gelb markiert sind Kunden mit noch offener Rechnung. Die Zahlungserinnerung oder ein neues Angebot geht an sie genauso wie an alle anderen.
- Im Zellenkommentar steht: „10 % Rabatt vereinbart“. Die Rechnung wird ohne Rabatt gestellt.
- Im Kommentar steht, dass der Kunde ab 1. November eine neue Adresse hat. Die Unterlagen gehen an die alte.
Ein Mensch, der die rote Zelle sieht, hält inne. Die Automatisierung geht daran vorbei.
Was ich tue. Ich hole die Bedeutung aus der Formatierung und lege sie in die Daten:
1. Ich bitte die Mitarbeitenden zu zeigen, welche Farben, Markierungen und Kommentare sie verwenden, und frage jeden, was sie bedeuten. Die Antworten verschiedener Personen vergleiche ich: Abweichungen sind hier oft das Wichtigste. 2. Für jede Bedeutung entscheide ich, ob die Automatisierung sie braucht. Wenn ja, bekommt sie ein eigenes Feld: Status „nicht kontaktieren“, Höhe des Rabatts, Datum der Adressänderung. Wenn nein, bleibt die Markierung, wie sie ist. 3. Ich übertrage die vorhandenen Markierungen in diese Felder, zuerst bei den Einträgen, die die Automatisierung als Erstes berührt. 4. Ich vereinbare mit dem Team, dass Neues in ein Feld geschrieben wird und nicht durch Farbe ausgedrückt. Die Formatierung darf als Komfort bleiben, aber nicht als einziger Ort, an dem Bedeutung steckt.
Warum das wichtig ist: Daten für eine Automatisierung müssen Daten sein, nicht Formatierung. Was nur ein Mensch sieht, berücksichtigt die Automatisierung nicht.
Orange Zone: das Ergebnis stimmt, aber es kostet Zeit. Ich gehe es nach Plan an
„Kein Problem, Anna gleicht das in fünf Minuten von Hand ab“
Was dahintersteckt. Anna kopiert Daten aus dem CRM in die Rechnung, prüft den Firmennamen, fragt eine Kollegin, welcher Status stimmt, und öffnet Excel, um herauszufinden, welche Angabe aktuell ist. Jedes Mal sind das nur fünf Minuten. Aber sie macht das nicht nur einmal.
Wo die Zeit verloren geht. Rechnen wir an einem fiktiven Beispiel: 10-mal am Tag × 5 Minuten × 220 Arbeitstage = rund 183 Stunden im Jahr pro Person. Die Zahlen sind erfunden: Das ist eine Veranschaulichung, kein Studienergebnis und keine Daten aus einem realen Projekt. Entscheidend ist das Prinzip: Aus „fünf Minuten“ werden mehrere Arbeitswochen. Und diese Zeit zählt niemand, weil sie nirgends erfasst wird.
Zu Excel noch ein Wort. Es dient oft als „Ersatz“-Wahrheitsquelle, kann aber ebenfalls fehlerhaft sein. Der Forscher Raymond Panko hat in einem Überblick die Ergebnisse von Prüfungen realer Arbeitstabellen zusammengetragen. Die Prüfungen seit 1997 (insgesamt 54 Tabellen) fanden in 86–91 % der Tabellen Fehler.** Daten, die man von Hand über eine Tabelle abgleicht, sind also nicht zwangsläufig genauer als das System.
Was ich tue. Ich messe einen Arbeitstag:
1. Ich bitte die Mitarbeitenden, jeden Fall festzuhalten: was sie kopiert haben, aus welchem System in welches, was sie nachgeprüft und wen sie gefragt haben. Ein Blatt Papier oder eine einfache Tabelle genügt. 2. Am Ende des Tages gruppiere ich: was am häufigsten vorkommt und wie viele Minuten jede Art von Tätigkeit kostet. 3. Ich sortiere nach der Summe der verlorenen Zeit. Die ersten drei Punkte zeigen, wo sich Automatisierung am schnellsten lohnt oder wo die Daten an der Quelle korrigiert werden müssen.
Warum das wichtig ist: Diese Messung liefert eine fertige Prioritätenliste, und wer entscheidet, wohin das Geld fließt, sieht Zahlen statt Meinungen.
„Sonderfälle sind selten, die automatisieren wir einfach mit“
Was dahintersteckt. Angenommen, 95 % der Aufträge laufen gleich ab. Die übrigen 5 % (die Prozentzahlen sind fiktiv) sehen so aus: Sonderpreise, nicht standardisierte Verträge, manuelle Rabatte, Ausnahmen je nach Land, individuelle Zahlungsbedingungen, eigene Regeln für Großkunden.
Wo die Zeit verloren geht. Jede Ausnahme ist ein weiterer Zweig in der Automatisierung: IF → ELSE → Router → Filter → Manual Review. Aus einem einfachen Ablauf wird ein Gebilde, das ständig gepflegt werden muss:
- Bei jeder Änderung der Bedingungen muss jemand alle Zweige prüfen, nicht nur einen;
- wenn ein Zweig bricht, muss die Ursache jemand suchen, der ihn nicht gebaut hat;
- das Wissen, warum die Ausnahme überhaupt existiert, steckt nicht selten in einem einzigen Kopf.
Diese Stunden fließen selten ins Budget ein, denn zum Start lief ja alles.
Was ich tue. Ich schreibe die Ausnahmen auf und halte für jede fest:
1. Welcher Anteil der Aufträge auf sie entfällt und wie viel Zeit die manuelle Bearbeitung kostet. 2. Wer entscheidet, dass es eine Ausnahme ist, und woran. 3. Ob das Geschäft sie braucht. Manchmal stellt sich heraus, dass ein Rabatt, den vor Jahren ein einzelner Kunde bekam, aus Gewohnheit bis heute gilt.
Danach gibt es für jede Ausnahme drei mögliche Wege: aus dem Prozess streichen, manuell lassen oder gesondert und bewusst automatisieren. Nicht selten ist es am günstigsten, den Prozess selbst zu ändern, statt noch einen Filter einzubauen.
Grüne Zone: Daten, die die Automatisierung nicht nutzt, können warten
Das sind Felder, die die Automatisierung weder liest noch ändert. Alte Einträge außerhalb ihres Bereichs. Optionale Daten, von denen keine Regel abhängt.
So unterscheiden Sie Grünes vom Rest: Schreiben Sie alle Felder auf, die Ihre Automatisierung verwendet. Was nicht auf dieser Liste steht, können Sie vorerst in Ruhe lassen. Ich halte das nicht für Faulheit, sondern für Prioritäten: Bereinigen sollte man, worauf sich die Automatisierung stützt, nicht einfach alles.
Checkliste vor dem Start
Das Ganze lässt sich in acht Schritte fassen, die ich in dieser Reihenfolge gehe:
Benennen Sie das führende Objekt. Was automatisieren Sie: den Kunden, das Unternehmen, den Deal, die Bestellung?
Finden Sie die Quelle der Wahrheit. In welchem System liegt die aktuelle Version jedes kritischen Werts, und was passiert, wenn Systeme voneinander abweichen?
Halten Sie die Felddefinitionen fest. Was bedeutet jedes Feld, auf das sich eine Regel stützt, und wer darf es ändern?
Prüfen Sie unmögliche Kombinationen. Erstellen Sie eine Liste nach dem Muster „So etwas kommt nicht vor“ und lassen Sie die Datenbank dagegen laufen.
Prüfen Sie alles, was von außen kommt. Gehen Sie den Weg vom Formular bis ins letzte System mit „unbequemen“ Werten durch: Anführungszeichen, Umlaute, Leerzeichen, langer Text.
Holen Sie die Bedeutung aus Farben und Kommentaren. Alles, was Entscheidungen beeinflusst, gehört in Felder, nicht in die Formatierung.
Machen Sie den Ein-Kunden-Test. Ein realer Kunde, der ganze Weg, alle Systeme.
Entscheiden Sie, was bei einem Fehler passiert. Wohin gelangt ein Eintrag, der sich nicht verarbeiten ließ, und wer erfährt davon?
Danach ordnen Sie das Gefundene den Zonen zu: Rotes beheben Sie vor dem Start, Orangefarbenes kommt in den Plan, Grünes bleibt für später.
Automatisierung ist ein guter Verstärker. Die Frage ist, was sie verstärkt
Ich bin für Automatisierung. Gerade deshalb lautet meine erste Frage nicht „Make oder Zapier?“ und auch nicht „Können wir hier KI einsetzen?“. Sie ist unbequemer: Welchen Daten können in diesem Prozess Menschen und Systeme gleichermaßen vertrauen?
Ist die Antwort gefunden, arbeitet die Automatisierung schneller, häufiger und ohne Ermüdung, und darin liegt ihre Stärke. Wenn nicht, vervielfacht sie die Abweichungen mit derselben Effizienz. Ein Mensch, der einen seltsamen Eintrag sieht, denkt: „Hier stimmt etwas nicht.“ Eine Automatisierung denkt nicht, sie führt die Bedingung aus.
Erst die Datenlogik. Dann der Prozess. Dann die Technologie.
Anmerkung. Die Gartner-Umfrage gibt Selbsteinschätzungen von Führungskräften wieder, keine unabhängige Prüfung; die Prognose bezieht sich auf KI-Projekte und ist eine Erwartung der Analysten, kein Messergebnis. ** Pankos Überblick betrifft Tabellen, nicht CRM-Systeme, und umfasst nur eine geringe Zahl von Prüfungen; er ist als Erinnerung zu lesen, nicht als Normalwert. Die Beispiele im Artikel (Müller, Anna, Prozentwerte, Zeiträume in Definitionen, Sonderzeichen, Farben) sind illustrativ, keine dokumentierten Fälle. Der Fall mit den Anführungszeichen im Formular ist eine Beobachtung aus einer einzelnen Praxis, keine Statistik. In Ihrem Unternehmen kann es anders sein: Genau dafür sind die Zonen da, damit Sie auf Ihre Situation schauen und nicht auf eine durchschnittliche.
Quellen
- Gartner, „Lack of AI-Ready Data Puts AI Projects at Risk“, Pressemitteilung vom 26.02.2025 (Umfrage unter Verantwortlichen für Datenmanagement, Juli 2024): gartner.com
- R. R. Panko, „Spreadsheet Errors: What We Know. What We Think We Can Do“, 2008, Tabelle der Feldprüfungen: arxiv.org